Ollaya คือเครื่องมือโอเพนซอร์สสำหรับรันโมเดลตัดสินใจ (decision model) ในเครื่องตัวเอง วางตำแหน่งตัวเองเป็น “Ollama สำหรับโมเดลตัดสินใจ” คือรับคำถามแบบมีโครงสร้าง (เลือกตัวเลือก ให้คะแนน หรือตอบใช่/ไม่ใช่) พร้อมข้อมูลอย่างข้อความหรือ JSON แล้วคืนค่าความน่าจะเป็นที่ผ่านการ calibrate มาแล้วภายในเวลาไม่กี่สิบมิลลิวินาที โดยไม่ต้องส่งข้อมูลออกนอกเครื่อง
จุดต่างจาก LLM ทั่วไปคือ Ollaya ไม่ต้อง generate token ทีละตัว แต่ตอบในการ forward pass เดียว ทำให้เร็วกว่าการเรียกแชตบอตมาก ตัวโปรเจกต์เป็นโอเพนซอร์สภายใต้สัญญาอนุญาต Apache-2.0 ใช้งานฟรี ไม่มีค่าใช้จ่ายต่อ token
Ollaya คืออะไร ในประโยคเดียว
Ollaya เหมาะกับนักพัฒนาและทีมที่อยากรันโมเดลตัดสินใจโอเพนซอร์สในเครื่องตัวเอง โดยเน้นควบคุมข้อมูลและความเร็ว แต่ยังต้องอ่าน benchmark ของแต่ละโมเดลเองก่อนเลือกใช้งานจริง เพราะความแม่นยำต่างกันมากระหว่างโมเดลขนาดเล็กกับขนาดใหญ่ ถ้าต้องการความง่ายแบบเรียก API สำเร็จรูป หรือใช้ LLM ทั่วไปสำหรับงานสนทนา Ollaya อาจไม่ใช่คำตอบที่ตรงจุดที่สุดครับ
หน้าตาและคำสั่งใช้งานของ Ollaya
Ollaya ออกแบบ CLI ให้คุ้นมือคนที่เคยใช้ Ollama อยู่แล้ว คำสั่งหลักคือ serve (รัน daemon), run, pull, list, ps, show, rm, cp, stop และ create ซึ่งทำหน้าที่ตรงตามชื่อเหมือนใน Ollama ทุกคำสั่ง แถมยังมีคำสั่ง mcp สำหรับเปิดให้เครื่องมือ agent อื่นเรียกใช้ Ollaya ผ่าน Model Context Protocol ได้โดยตรง
ถ้าไม่ได้สั่ง ollaya serve เอง ตัว CLI จะเปิด daemon ให้อัตโนมัติเมื่อสั่งคำสั่งอื่นเข้ามา ทำให้ขั้นตอนเริ่มต้นสั้นลงกว่าต้องตั้ง service เอง
จากการลองโมเดลตัดสินใจเอง สู่เครื่องมือที่ใช้งานได้จริง
คนที่อยากลองโมเดลตัดสินใจแบบโอเพนซอร์สมักเจอปัญหาเดิม ต้องไปโหลดน้ำหนักโมเดลจาก Hugging Face เอง เขียน wrapper แปลงคำถามเป็น prompt แล้วยังต้อง parse คำตอบให้เป็นความน่าจะเป็นด้วยตัวเอง
Ollaya รวมขั้นตอนพวกนี้ไว้ใน CLI เดียว โมเดลที่ pull มาจะมาพร้อมการตรวจสอบ SHA256 และเวอร์ชันที่ pin ไว้ชัดเจน ผู้ใช้จึงโฟกัสกับการออกแบบคำถามและ threshold การตัดสินใจ แทนที่จะเสียเวลาจัดการไฟล์โมเดลเอง
Ollaya อยู่ตรงไหนในโลกของเครื่องมือรันโมเดล
Ollama คือชั้นที่ช่วยรัน LLM ทั่วไปในเครื่องได้ง่ายขึ้น ส่วน Ollaya โฟกัสเฉพาะกลุ่มโมเดลตัดสินใจ (decision model) ที่ตอบคำถามแบบมีโครงสร้างแทนการสนทนาอิสระ
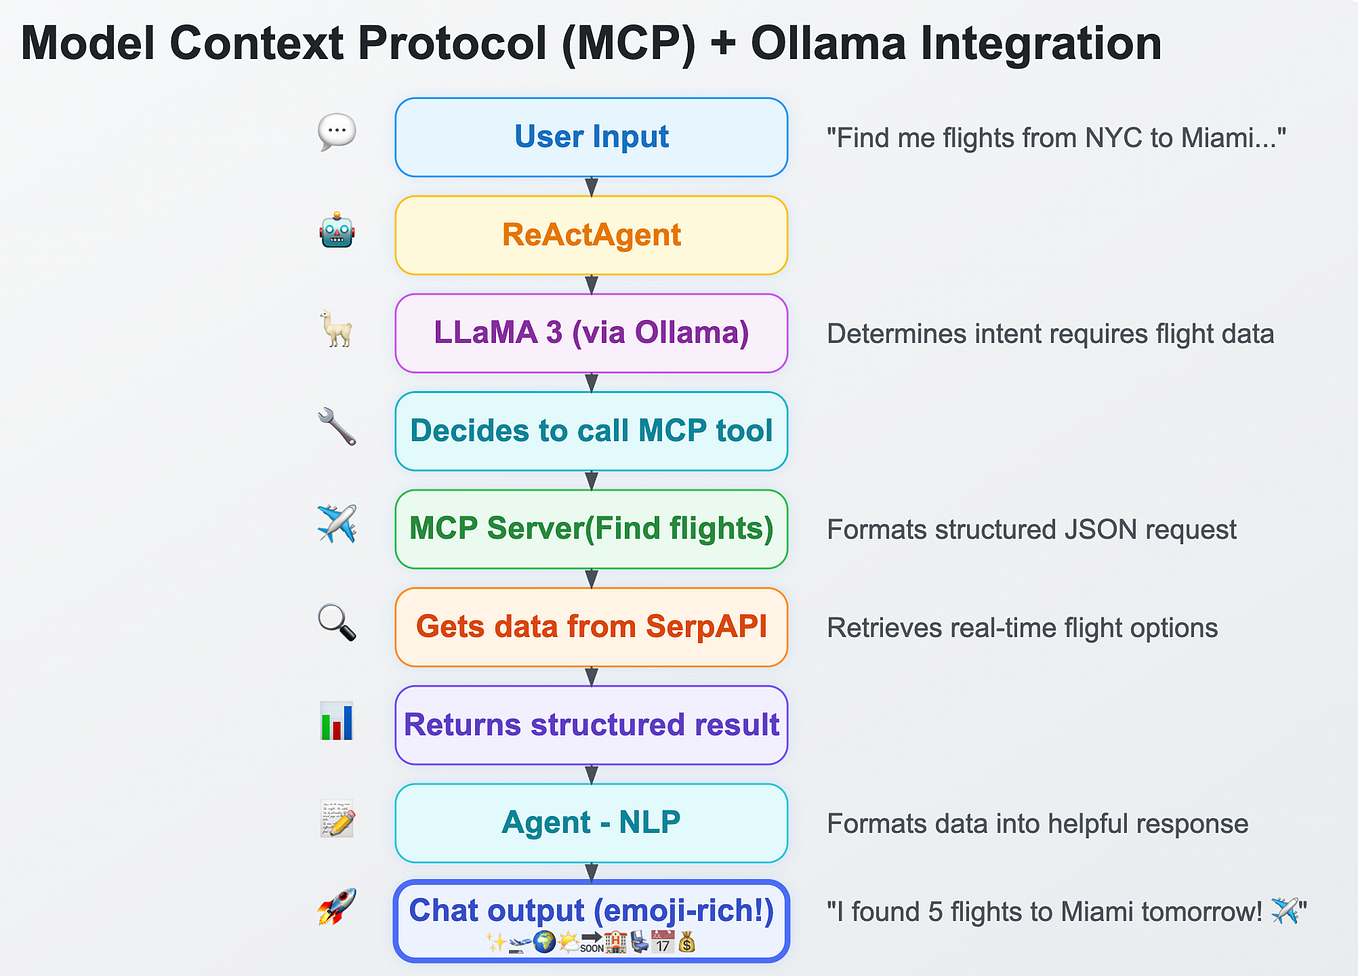
เมื่อเชื่อมกับคำสั่ง ollaya mcp เครื่องมือประเภท agent ที่รองรับ Model Context Protocol เรียกใช้ Ollaya เป็นอีกหนึ่ง tool ในขั้นตอนการตัดสินใจได้ เช่น ให้ agent หลักตัดสินใจว่าจะเรียกเครื่องมือไหนต่อ โดยไม่ต้องเสีย token ไปกับการให้ LLM ขนาดใหญ่ตอบคำถามแบบ yes/no ธรรมดา
ตัวเลขที่วัดได้จริง: ความเร็วและความแม่นยำของแต่ละโมเดล
| Factor | winnow:e4b | laya:en | decider:4b | kev:9b |
|---|---|---|---|---|
| ความแม่นยำ (typed-decisions benchmark) | 0.722 (ชุด Jev: 0.738) | ไม่ระบุแยก เน้นความเร็วเป็นหลัก | 0.680 | 0.722 |
| ความเร็ว (5 คำถามบน RTX 4090) | 89 ms | 8–10 ms | ไม่ระบุแยกในเอกสาร | ไม่ระบุแยกในเอกสาร |
| จุดเด่น | แม่นยำสูงสุดในกลุ่มที่มีตัวเลข | เร็วที่สุด เหมาะกับ CPU ด้วย | ขนาดกลาง สมดุลความแม่นยำ/ทรัพยากร | แม่นยำเทียบเท่า winnow:e4b |
ตัวเลขจากเอกสารของโปรเจกต์เองแสดงให้เห็นว่า laya:en เป็นตัวเร็วที่สุด เหมาะกับงานที่ต้องตอบสดจำนวนมาก ส่วน winnow:e4b แลกความเร็วเพื่อความแม่นยำที่สูงกว่า benchmark ทั้งหมดเป็นตัวเลขที่ทีม Ollaya วัดเอง ควรทดสอบซ้ำกับข้อมูลจริงของแต่ละงานก่อนตัดสินใจเลือกโมเดล
เมื่อ Ollaya ถูกนำไปใช้ในสถานการณ์จริง
Ollaya เหมาะกับงานที่ต้องรันโมเดลภายในเครื่อง เช่น คัดกรองข้อความหรือคำขอที่ไม่ควรส่งข้อมูลออกนอกระบบ ทีมยังเลือกใช้โมเดลจากทั้งแปดตระกูลที่ Ollaya รองรับ ได้แก่ winnow, laya, decider, kev, nli, gliclass, qwen3guard และ von เพื่อเปรียบเทียบความแม่นยำกับความเร็วก่อนใช้งานจริง
ถ้างานมีเงื่อนไขหลายชั้น เช่น ต้องตรวจสอบเนื้อหาก่อนส่งต่อให้ LLM ตัวใหญ่ Ollaya ช่วยกรองด้วย decision model ที่เร็วกว่าได้ก่อน ลดภาระของโมเดลหลักและลดค่าใช้จ่ายต่อ token ที่ไม่จำเป็น
ภาพรวมจึงเหมาะกับทีมที่ต้องการควบคุมทั้งโมเดล ข้อมูล และงบประมาณการเรียกใช้ LLM ไว้ในระบบเดียวกัน
Ollaya เทียบกับทางเลือกที่คนใช้อยู่แล้ว
| Factor | Ollaya | Ollama | เรียก LLM ผ่าน API คลาวด์ | เขียน classifier เอง |
|---|---|---|---|---|
| เริ่มต้นใช้งาน | ติดตั้ง CLI แล้ว pull โมเดลได้ทันที | ติดตั้งง่าย เน้นรัน LLM ทั่วไป | สมัคร API key แล้วเรียกได้ทันที | ต้องเก็บข้อมูล เทรน และดูแลเอง |
| รองรับโมเดล | โมเดลตัดสินใจ 8 ตระกูลจาก Hugging Face | ไลบรารี LLM ทั่วไปจำนวนมาก | ขึ้นกับผู้ให้บริการ | กำหนดเองได้ทั้งหมด |
| ความเป็นส่วนตัว | รันในเครื่อง ข้อมูลไม่ออกนอกระบบ | รันในเครื่อง | ข้อมูลผ่านคลาวด์ของผู้ให้บริการ | ควบคุมได้เต็มที่ |
| ความเร็ว | 8–89 ms ต่อชุดคำถาม ขึ้นกับโมเดล (อ้างอิง RTX 4090) | ขึ้นกับขนาดโมเดลและฮาร์ดแวร์ | ขึ้นกับเครือข่ายและคิวของผู้ให้บริการ | ขึ้นกับสถาปัตยกรรมที่เลือกเอง |
| ต้นทุน | ฟรี (Apache-2.0) ใช้ทรัพยากรเครื่องตัวเอง | ฟรี ใช้ทรัพยากรเครื่องตัวเอง | จ่ายตามการใช้งานต่อ token | ต้นทุนพัฒนาและดูแลระบบเอง |
| เหมาะกับใคร | ทีมที่ต้องตอบคำถามแบบมีโครงสร้างจำนวนมาก | คนที่อยากรัน LLM ทั่วไปในเครื่อง | ทีมที่อยากเริ่มเร็วไม่อยากดูแลระบบ | ทีมที่มีโจทย์เฉพาะทางมากจริงๆ |
ถ้าต้องการแค่รันโมเดลสนทนาแบบ LLM ทั่วไป Ollama ตรงกว่า แต่ Ollaya เด่นเฉพาะงานตอบคำถามแบบมีโครงสร้างที่ต้องได้ความน่าจะเป็นกลับมา ส่วนบริการคลาวด์เริ่มง่ายกว่าแต่แลกกับการควบคุมข้อมูลที่น้อยลงและค่าใช้จ่ายต่อ token ที่สะสมได้เรื่อยๆ
จุดแข็งที่ชัดเจน และข้อจำกัดที่ต้องยอมรับ
ข้อดี
- +โอเพนซอร์สและฟรีทั้งหมด ไม่มีค่า API ต่อ token
- +รันในเครื่องเอง ข้อมูลไม่ต้องออกนอกระบบ
- +ตอบเร็วระดับหลักสิบมิลลิวินาที เพราะไม่ต้อง generate token ทีละตัว
- +รองรับตั้งแต่ CPU ไปจนถึง GPU NVIDIA และ Apple Silicon ผ่าน MLX
ข้อเสีย
- −ต้องเลือกโมเดลเองจากแปดตระกูล และแต่ละตัวความแม่นยำต่างกันพอสมควร
- −โปรเจกต์เพิ่งเปิดตัว เอกสารและตัวอย่างการใช้งานยังไม่เยอะ
- −โมเดลที่แม่นยำกว่าอย่าง winnow:e4b ต้องแลกกับเวลาตอบที่นานขึ้น
- −ต้องเข้าใจเรื่อง threshold และ calibration เพื่อใช้ผลลัพธ์อย่างถูกต้อง
ต้นทุนที่แท้จริงของการรันโมเดลตัดสินใจเอง
ตัว Ollaya เองไม่มีค่าใช้จ่าย เพราะเป็นซอฟต์แวร์โอเพนซอร์สภายใต้ Apache-2.0 ต้นทุนจริงจึงอยู่ที่ฮาร์ดแวร์ที่มีอยู่แล้วกับเวลาที่ใช้ตั้งค่า ถ้าใช้ GPU ฝั่ง NVIDIA ต้องมี CUDA 12 หรือ 13 พร้อมไดรเวอร์ตั้งแต่ R525 ขึ้นไป ส่วนเครื่อง Apple Silicon ใช้ผ่าน MLX ได้โดยตรง หรือจะรันบน CPU อย่างเดียวก็ได้ โดยเฉพาะโมเดลตระกูล laya ที่ออกแบบมาให้เบา
อีกต้นทุนที่มักถูกมองข้ามคือเวลาเปรียบเทียบโมเดลทั้งแปดตระกูลกับงานจริง เพราะความแม่นยำต่างกันตั้งแต่ 0.36 ถึง 0.738 บน benchmark ที่โปรเจกต์เผยแพร่เอง ถ้าเลือกโมเดลผิดขนาดหรือไม่ตั้ง threshold ให้เหมาะ ผลลัพธ์อาจดูมั่นใจแต่ผิดบริบทได้เหมือนกันครับ
ใครควรเริ่มใช้ Ollaya และใครควรรอ
เหมาะกับ
- นักพัฒนาที่อยากทดลองโมเดลตัดสินใจโอเพนซอร์ส
- ทีมที่ต้องเก็บข้อมูลไว้ภายในองค์กร ส่งออกนอกระบบไม่ได้
- ทีมที่อยากลดภาระ token ของ LLM หลักด้วยการกรองงานง่ายๆ ก่อน
ลองชั่งน้ำหนักดู
- ผู้ที่ยังไม่คุ้นกับแนวคิด calibrated probability และการตั้ง threshold
ข้ามได้เลย
- ผู้ต้องการแชตบอตทั่วไป — ใช้ Ollama หรือบริการ LLM สำเร็จรูปแทน
- ผู้ต้องการความแม่นยำระดับโปรดักชันทันที — ควรทดสอบ benchmark กับข้อมูลจริงก่อน
ถ้าจะลอง Ollaya ควรเริ่มจากคำถามไหน
เริ่มจาก “คำถามแบบมีโครงสร้างอะไรที่อยากให้โมเดลตอบ” เช่น คัดกรองข้อความเข้าข่ายสแปมหรือไม่ ให้คะแนนความเสี่ยง หรือเลือกตัวเลือกจากรายการที่กำหนดไว้ เพราะ Ollaya ออกแบบมาเพื่อคำถามประเภท choice, score และ yes/no ไม่ใช่บทสนทนาอิสระ
จากนั้นเช็กเครื่องก่อน ถ้ามี GPU NVIDIA ต้องมี CUDA 12 หรือ 13 กับไดรเวอร์ R525 ขึ้นไป ถ้าใช้ Mac ใช้ผ่าน MLX ได้เลย หรือจะเริ่มจาก CPU ด้วยโมเดล laya ก่อนก็ได้ เพราะเบาที่สุดในกลุ่ม
สุดท้ายให้ทดสอบกับชุดคำถามจริงของงาน วัดทั้งความเร็วและความแม่นยำเทียบกับ threshold ที่ต้องการ ก่อนตัดสินใจว่าจะใช้ winnow:e4b ที่แม่นยำกว่าแต่ช้ากว่า หรือ laya:en ที่เร็วแต่ต้องยอมรับความแม่นยำที่ลดลง