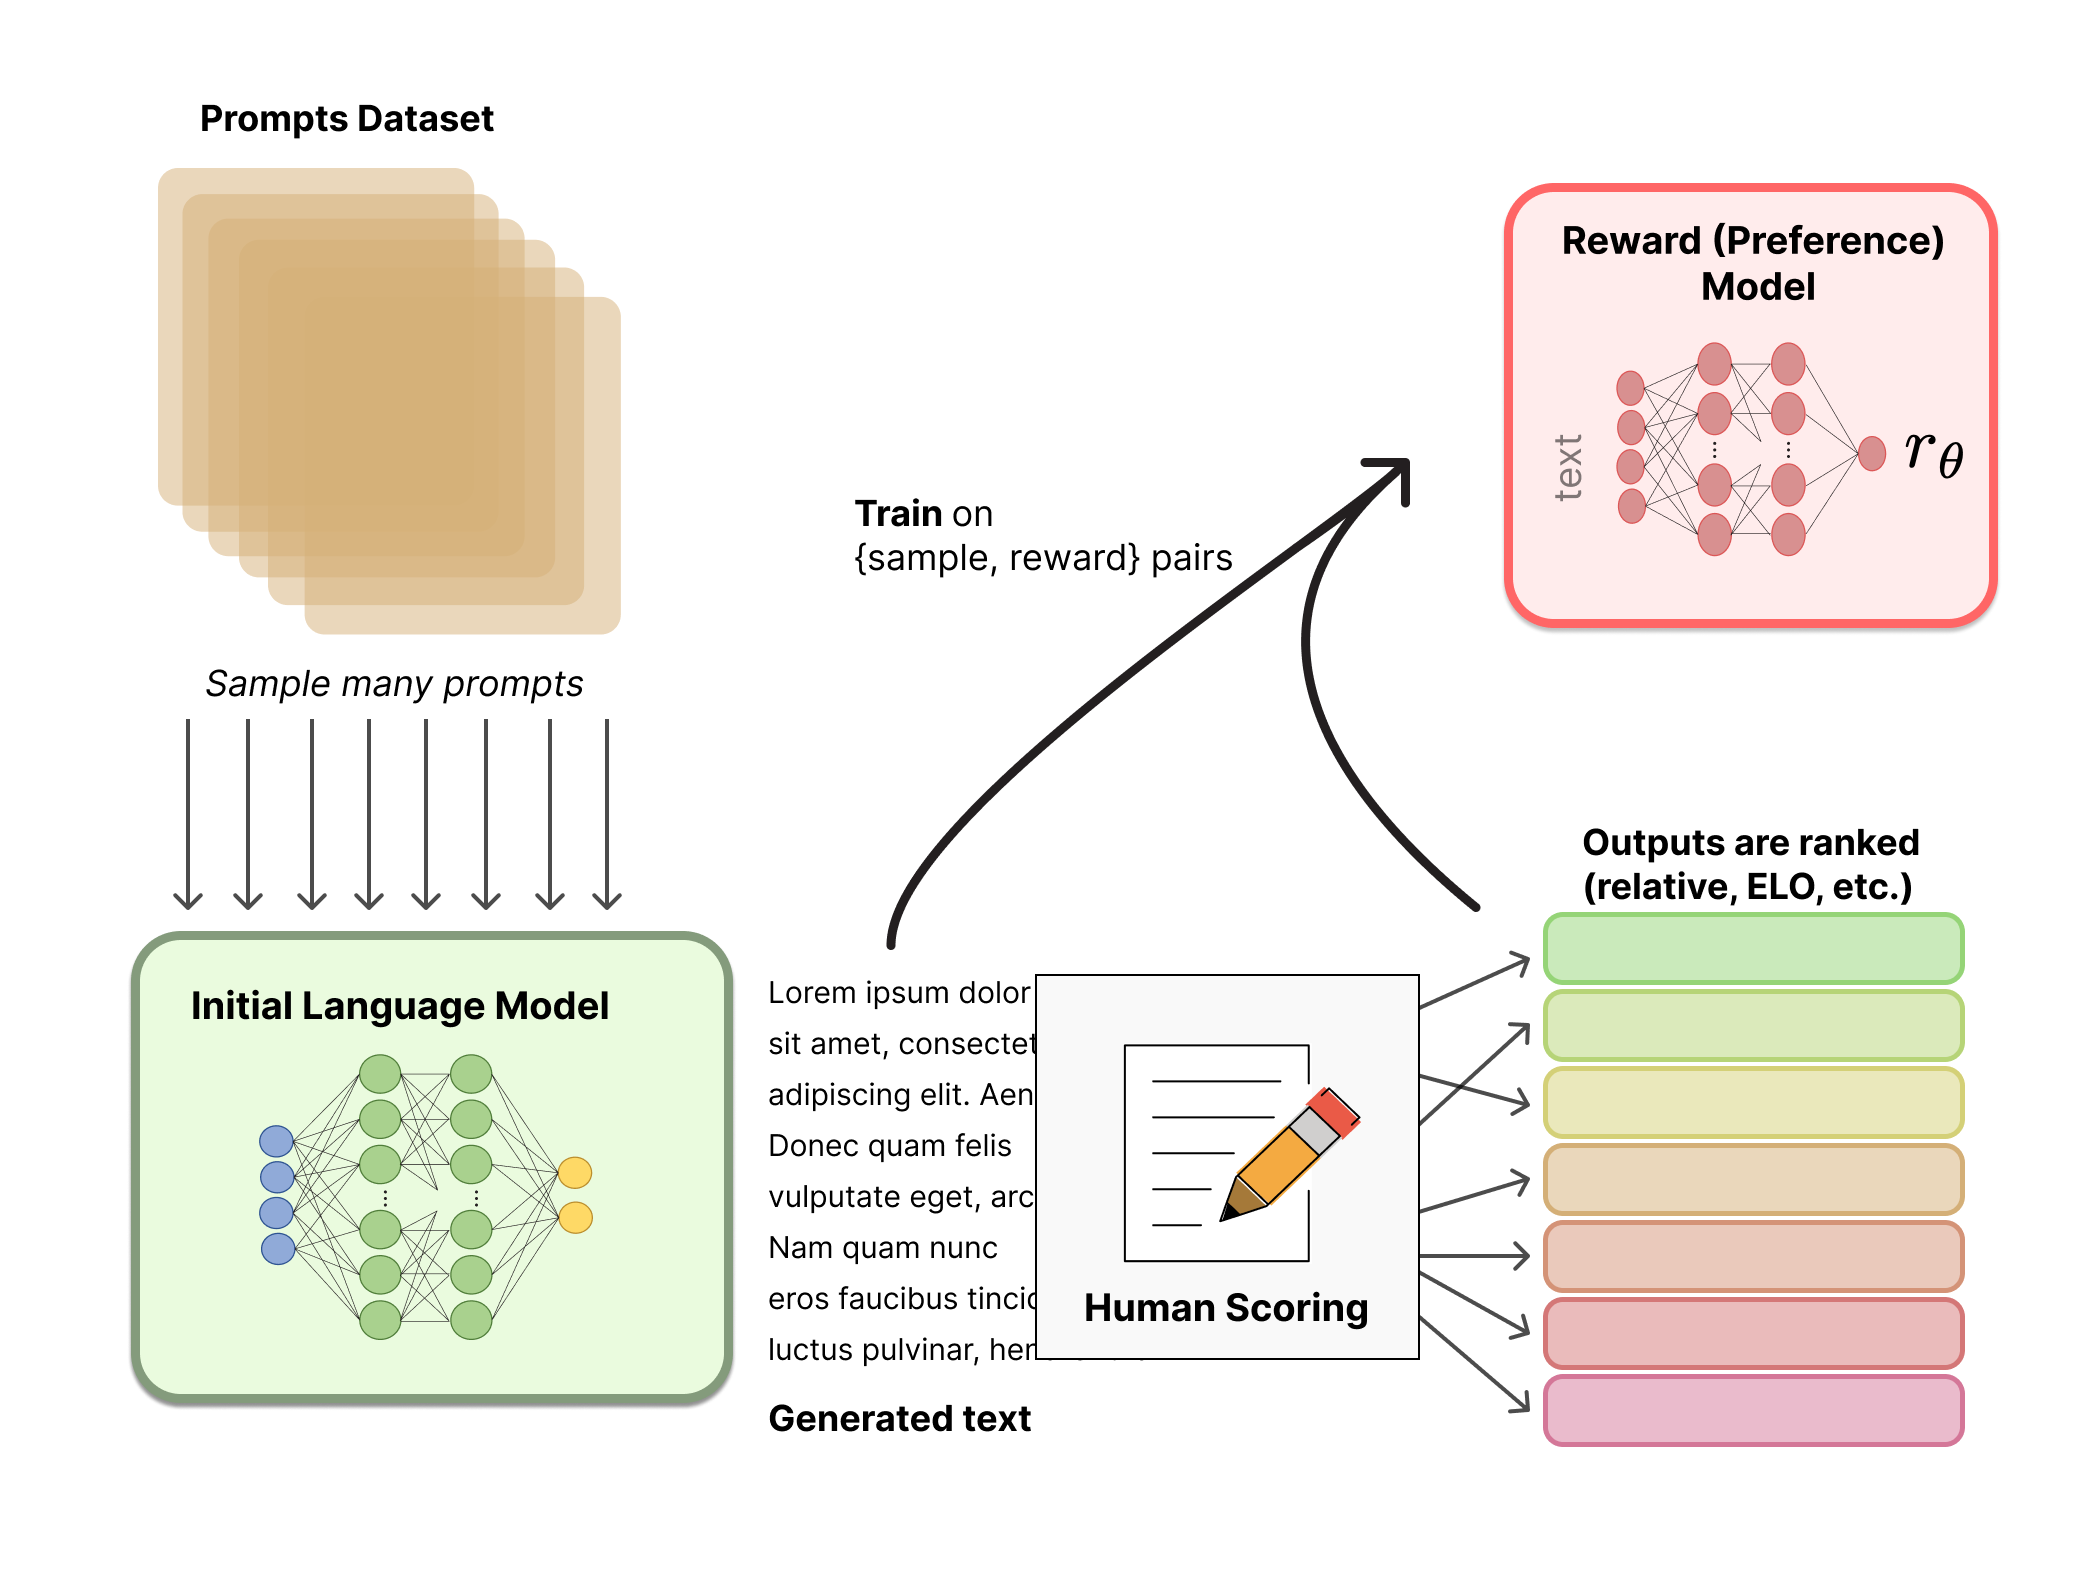
Cloudflare เปิดตัว Clef เป็นตระกูลโมเดลตัดสินใจแบบ open-weight บน Workers AI พร้อมแพลตฟอร์ม fine-tuning ด้วย reinforcement learning ที่ให้ทีมนำข้อมูลการใช้งานจริงกลับมาปรับพฤติกรรมโมเดลได้ แทนที่จะพึ่งแค่การแก้ prompt
จุดที่ต้องระวังคือคุณภาพข้อมูล ความพร้อมของทีม และต้นทุนการรันระยะยาว ถ้าข้อมูลไม่ดีหรือไม่มีคนดูแล การเปิดโมเดลให้ปรับแต่งได้ก็ไม่ได้แปลว่าจะได้ผลลัพธ์ที่ดีขึ้นเสมอไป
Clef แก้ปัญหาอะไรให้คนสร้าง AI
Clef ไม่ได้ออกแบบมาให้ตอบคำถามแบบ LLM ทั่วไป แต่เน้นสร้าง “bounded structured output” คือผลลัพธ์แบบจัดหมวดหมู่ที่มีคะแนนความน่าจะเป็นกำกับ ได้เร็ว ถูก และสม่ำเสมอ โดยใช้สถาปัตยกรรมแบบ non-autoregressive ที่ให้คะแนนโดยตรงแทนการไล่ทำนายทีละ token
Cloudflare วาง Clef ให้เข้ามาแทนที่ Jev ซึ่งเป็นโมเดลตัดสินใจรุ่นก่อนของตัวเอง โดยทำ API ให้เข้ากันได้กับ Jev เพื่อให้ทีมที่ใช้งานอยู่แล้วสลับมาใช้ Clef ได้โดยไม่ต้องเขียนโค้ดเรียกใช้ใหม่
วันที่โมเดลตอบเก่ง แต่ตัดสินใจใช้งานจริงไม่ได้
ลองนึกภาพทีมพัฒนาให้โมเดลจัดการ ticket ลูกค้า คำตอบที่ได้ดูสุภาพและมีเหตุผล แต่กลับเลือกส่งเรื่องผิดทีม หรือวางแผนหลายขั้นตอนแล้วหลุดกลางทาง พอเจอสถานการณ์เดิมอีกครั้ง ผลลัพธ์ก็ไม่สม่ำเสมอจนทีมไว้ใจให้ทำงานเองไม่ได้
ปัญหาไม่ได้อยู่ที่โมเดล “พูดไม่เก่ง” แต่อยู่ที่การตัดสินใจและการลงมือทำ Clef จึงพยายามแก้ตรงนี้ด้วยโมเดลตัดสินใจแบบ open-weight และแพลตฟอร์ม RL fine-tuning ที่ช่วยปรับพฤติกรรมจากผลลัพธ์จริง พร้อมเปิดทางให้ทีมตรวจสอบและปรับโมเดลได้ละเอียดขึ้น
Clef อยู่ตรงไหนในโลกของโมเดลแบบเปิดน้ำหนัก
Clef มีสองรุ่น คือ Clef ตัวใหญ่ที่สร้างบน Qwen 27B เน้นความแม่นยำ และ Clef-flash ตัวเล็กที่สร้างบน Qwen 9B เน้นความเร็ว โดย Clef (ตัวใหญ่) มี vision encoder สำหรับจัดหมวดภาพได้ ซึ่ง Jev รุ่นก่อนไม่มี และรองรับ context window ยาวถึง 64k token เทียบกับ 32k ของ Jev ส่วน Clef-flash นั้นแหล่งข้อมูลยังไม่ได้ระบุว่ามีสองความสามารถนี้ด้วยหรือไม่
ทั้งสองรุ่นเผยแพร่แบบ open-weight ภายใต้สัญญาอนุญาต Apache 2.0 บน Hugging Face ดาวน์โหลดไปรันเองได้ และยังมีให้ใช้งานแบบ hosted บน Workers AI สำหรับทีมที่ไม่อยากดูแลโครงสร้างพื้นฐานเอง
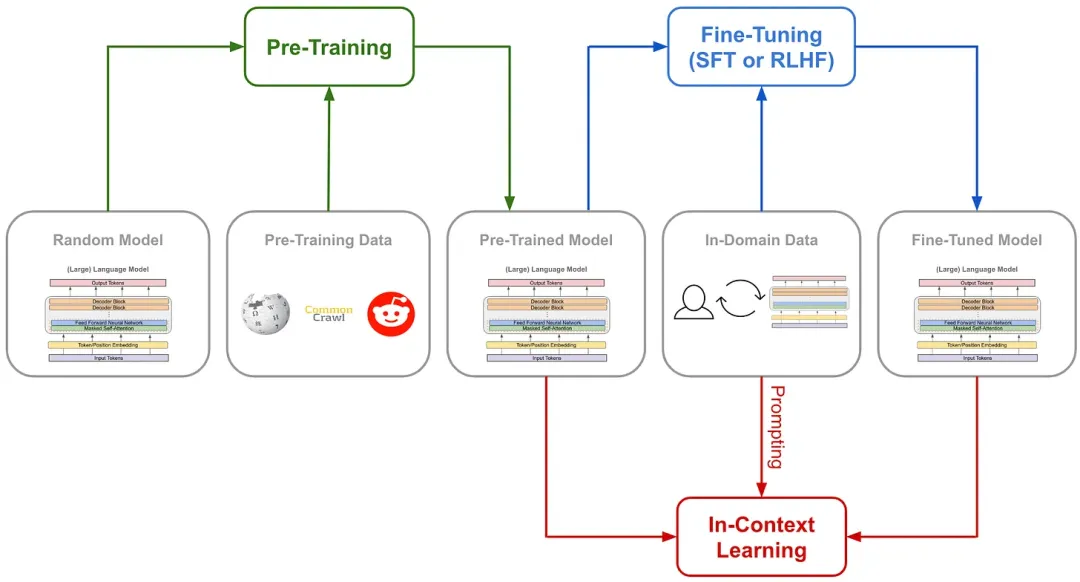
จาก Jev สู่ Clef: อัปเกรดที่มีตัวเลขรองรับ
Cloudflare เผยแพร่ผลทดสอบความเร็วจาก 43 benchmark โดย Clef ตอบที่ค่ากลาง (median) 209.3ms และ p95 ที่ 238.6ms ส่วน Clef-flash เร็วกว่ามากที่ median 38.8ms และ p95 122.4ms ขณะที่ Jev รุ่นก่อนอยู่ที่ median 524.1ms
ด้านคุณภาพ ตัวอย่างผลจาก Jev Decision Index พบว่า Clef-flash ทำ exact match บน BFCL ได้ 98.76% และความแม่นยำบน API-Bank 93.11% ส่วน Clef ทำ macro-F1 บน BANKING77 ได้ 94.20% และ nDCG@10 บน ToolRet 69.19% โดยรวมแล้ว Clef ทำผลงานดีกว่า Jev ใน 3 จาก 4 เวิร์กโฟลว์ทดสอบของ Typesafe ได้แก่ invoice processing, customer service และ security incidents
| Factor | Jev (รุ่นก่อน) | Clef | Clef-flash |
|---|---|---|---|
| Base model | ไม่ระบุในซอร์ส | Qwen 27B | Qwen 9B |
| Latency median | 524.1ms | 209.3ms | 38.8ms |
| Latency p95 | ไม่ระบุในซอร์ส | 238.6ms | 122.4ms |
| Context window | 32k token | 64k token | ไม่ระบุในซอร์ส |
| รองรับภาพ (vision) | ไม่รองรับ | รองรับ | ไม่ระบุในซอร์ส |
| สัญญาอนุญาต | ไม่ระบุในซอร์ส | Apache 2.0 | Apache 2.0 |
Cloudflare ยังทดสอบภายในด้วยงานจัดหมวดหมู่โดเมนเว็บไซต์ พบว่า Clef ใช้เวลาราว 2.2 วินาที เร็วกว่า gpt-oss-120b ที่ใช้ 4.7 วินาที และยังให้หมวดหมู่ผลลัพธ์ได้ละเอียดกว่าด้วย
ฟีเจอร์ของ Clef ทำงานจริงในสถานการณ์ไหน
โมเดลแบบเปิดน้ำหนักเหมาะกับทีมที่ต้องการรันโมเดลบนโครงสร้างพื้นฐานของตัวเอง และควบคุมข้อมูลภายในได้มากขึ้น
การปรับแต่งด้วย reinforcement learning เหมาะกับงานที่มีเกณฑ์วัดผลชัด แพลตฟอร์มของ Cloudflare ใช้ label-smoothed cross-entropy loss ร่วมกับ Brier loss เพื่อคาลิเบรตความน่าจะเป็น และมีเทคนิคใหม่ชื่อ RLCD (Reinforcement Learning for Calibrated Decisions) ที่ให้คะแนนบางส่วนกับตัวเลือกที่ใกล้เคียงคำตอบที่ถูก ไม่ใช่ตัดสินแบบถูก-ผิดเท่านั้น
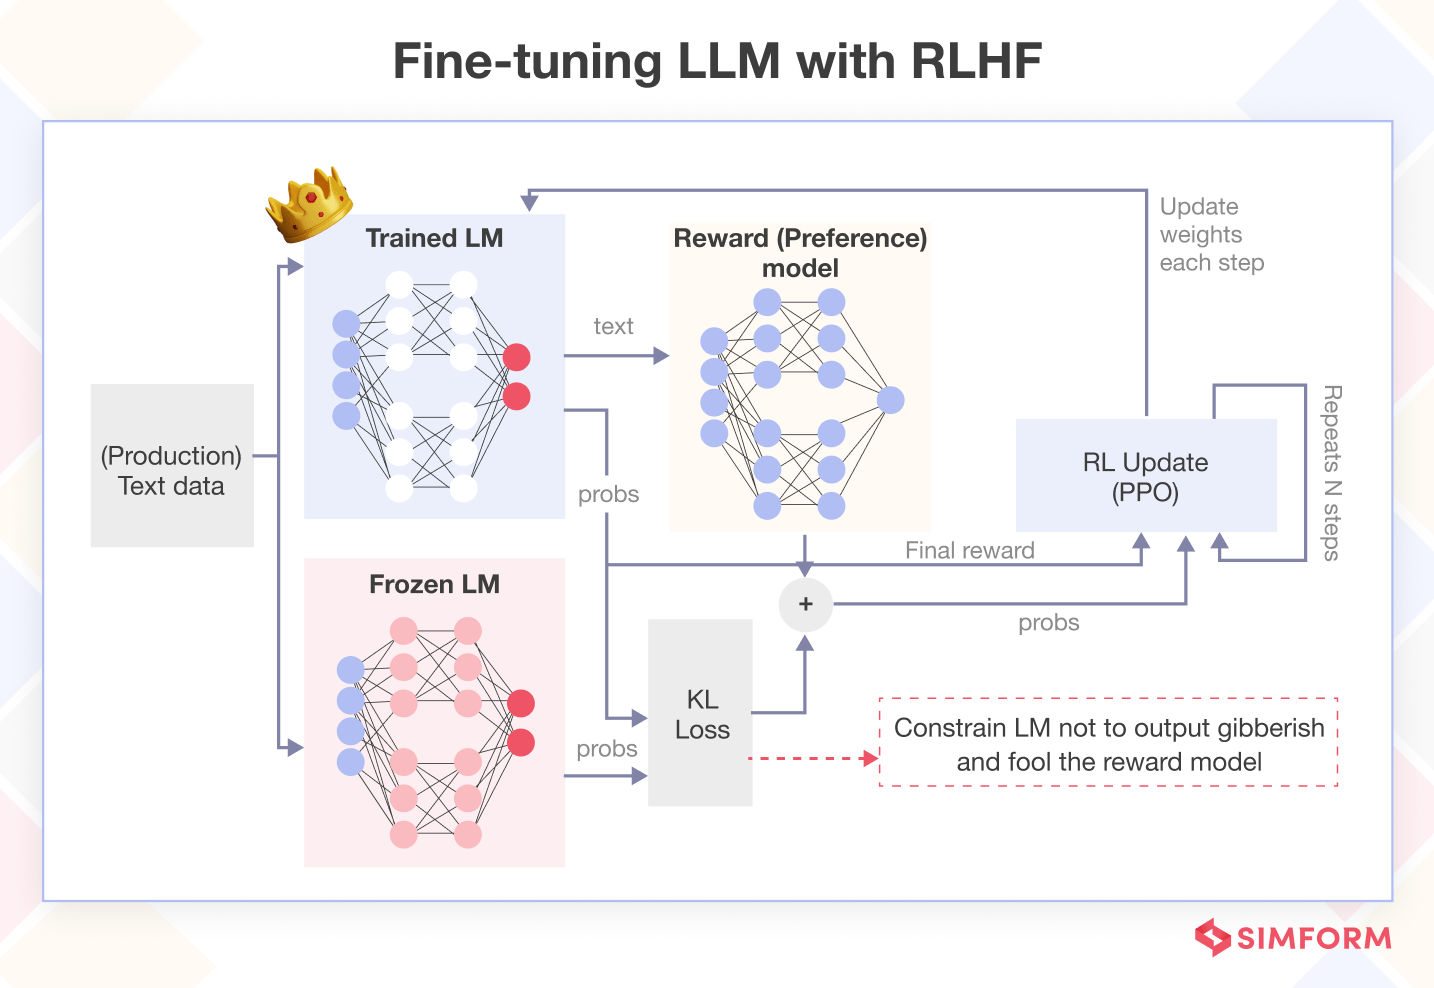
แนวคิดนี้ใกล้เคียงกับสิ่งที่แพลตฟอร์มของ Cloudflare ทำ คือมีโมเดลที่กำลังฝึกเทียบกับโมเดลตั้งต้น แล้วใช้ reward มาปรับน้ำหนัก โดยมี loss ควบคุมไม่ให้โมเดลหลุดจากพฤติกรรมเดิมมากเกินไป
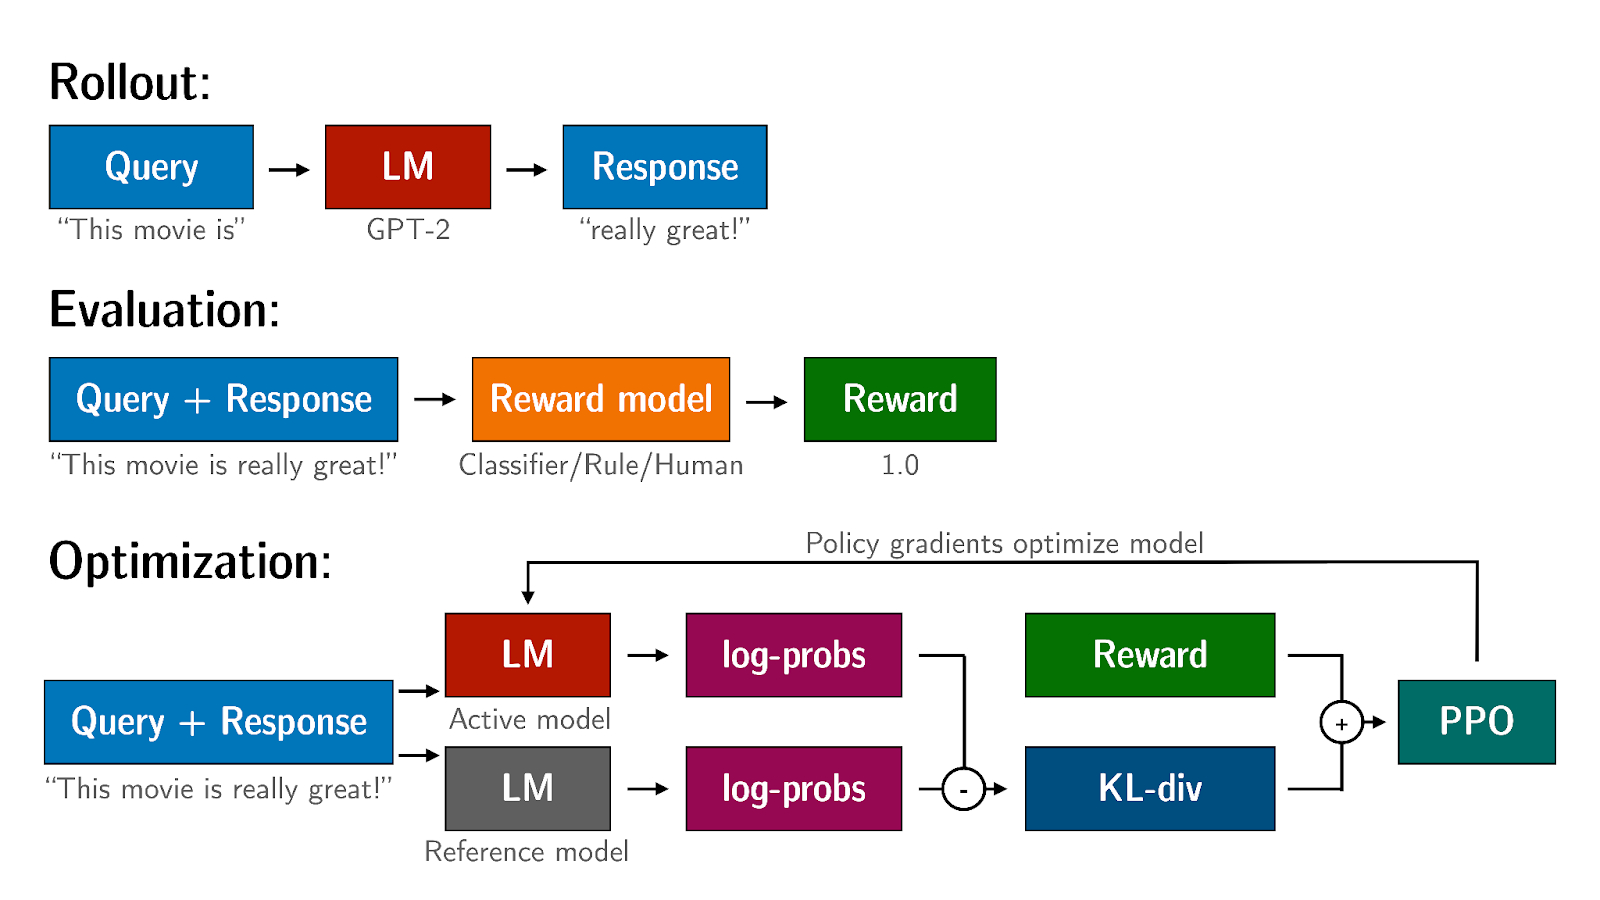
สถาปัตยกรรมฝึกของ Clef ใช้ two-stage attention routing ร่วมกับ low-rank adapter แบบ rank-256 ทำให้ปรับโมเดลได้โดยไม่ต้องฝึกทั้งโมเดลใหม่ทั้งหมด เหมาะกับ workflow ที่ต้องเรียกเครื่องมือหลายขั้นตอน เช่น ค้นข้อมูล เรียก API แล้วสรุปผลต่อเนื่องกัน
ถ้าเทียบกับทางเลือกอื่น Clef เด่นตรงไหน
| Factor | Clef | โมเดลปิดผ่าน API | แพลตฟอร์ม fine-tuning แบบดั้งเดิม | โมเดล open-weight รายอื่น |
|---|---|---|---|---|
| ความยืดหยุ่น | ปรับด้วย RL ตามงานตัดสินใจ | จำกัดตาม API | ปรับได้ตามชุดข้อมูล | ปรับแต่งเองได้ |
| ต้นทุน | ยังไม่เปิดเผยราคาเฉพาะ | มีค่าบริการต่อการเรียกใช้ | มีค่าโครงสร้างพื้นฐาน | ขึ้นกับการดูแลระบบ |
| การควบคุมข้อมูล | ควบคุม workflow และการนำไปใช้เอง | ต้องส่งข้อมูลให้ผู้ให้บริการ | ควบคุมชุดข้อมูลได้ | ควบคุมสภาพแวดล้อมได้ |
| เริ่มต้นใช้งาน | ต้องเข้าใจ RL และงานหลายขั้นตอน | เริ่มง่ายผ่าน API | ต้องเตรียมข้อมูลและขั้นตอนฝึก | ต้องดูแลระบบเอง |
| งานตัดสินใจหลายขั้นตอน | เหมาะโดยตรง | เหมาะเมื่อ API รองรับ | ต้องออกแบบเพิ่ม | ขึ้นกับการปรับแต่ง |
จุดแข็งที่เห็นชัด และจุดที่ยังต้องระวัง
Clef เด่นตรงที่มีตัวเลข benchmark รองรับชัดเจนทั้งความเร็วและความแม่นยำ เปิดน้ำหนักให้ตรวจสอบได้ และสลับจาก Jev ได้ทันทีเพราะ API เข้ากันได้
แต่แพลตฟอร์ม RL fine-tuning ของ Cloudflare ตอนนี้ยังอยู่ในช่วงทำงานร่วมกับทีม forward-deployed engineer โดยตรง ยังไม่เปิดเป็นบริการแบบ self-serve ให้ทุกทีมเข้าถึงเอง ความยืดหยุ่นนี้จึงมาพร้อมงานเตรียมข้อมูล การออกแบบ reward และการดูแลโครงสร้างพื้นฐานเอง
ข้อดี
- +มีผลทดสอบความเร็วและความแม่นยำจาก 43 benchmark ยืนยันชัดเจน
- +เปิดน้ำหนักโมเดลภายใต้ Apache 2.0 และสลับจาก Jev ได้ทันทีผ่าน API เดิม
ข้อเสีย
- −แพลตฟอร์ม RL fine-tuning ยังไม่เปิดแบบ self-serve ต้องทำงานร่วมกับทีม Cloudflare โดยตรง
- −ต้องเตรียมข้อมูลและออกแบบกระบวนการฝึกเอง ผลลัพธ์อาจไม่สม่ำเสมอ
ราคาที่ไม่ได้อยู่บนหน้าแพลตฟอร์ม
Cloudflare ยังไม่เปิดเผยราคาเฉพาะของ Clef หรือแพลตฟอร์ม RL fine-tuning ในประกาศนี้ สิ่งที่ชัดคือการ fine-tune ตอนนี้ต้องทำงานร่วมกับทีม forward-deployed engineer ของ Cloudflare โดยตรง ไม่ใช่ self-serve ที่กดเริ่มได้เอง ต้นทุนจึงยังขึ้นกับการเจรจาต่อโครงการ
นอกเหนือจากนั้นยังมีค่าที่มองไม่เห็นในป้ายราคา เช่น ค่า GPU สำหรับรันโมเดลเอง ค่าเตรียมข้อมูล และเวลาออกแบบ reward ให้สอดคล้องกับงานจริง เมื่อนำไปใช้ในองค์กรยังต้องบวกค่าแรงผู้เชี่ยวชาญ ค่า monitoring และการ evaluate ซ้ำหลังปรับโมเดลเข้าไปด้วย
ใครควรเริ่มใช้ Clef และใครควรรอ
Clef เหมาะกับทีมวิจัย ทีมสร้างเอเจนต์เฉพาะทาง และองค์กรที่ต้องควบคุมข้อมูลกับพฤติกรรมของโมเดลเอง โดยเฉพาะทีมที่ใช้ Jev อยู่แล้วและอยากได้ความเร็วเพิ่มโดยไม่ต้องแก้โค้ด
ส่วนทีมที่อยากได้บริการ fine-tuning แบบ self-serve ทันที หรือยังไม่มีข้อมูลสำหรับฝึก ควรรอจนกว่า Cloudflare จะเปิดแพลตฟอร์มให้เข้าถึงเองได้กว้างขึ้น
เหมาะกับ
- ทีมที่ใช้ Jev อยู่แล้วและต้องการอัปเกรดความเร็ว/ความแม่นยำโดย API เดิม
- ทีมสร้างเอเจนต์เฉพาะทางที่ต้องการโมเดลตัดสินใจแบบเปิดน้ำหนัก
- องค์กรที่ต้องควบคุมข้อมูลและพฤติกรรมของโมเดลเอง
ลองชั่งน้ำหนักดู
- ทีมที่มีข้อมูลสำหรับฝึกจำกัด
ข้ามได้เลย
- ทีมที่ต้องการ fine-tuning แบบ self-serve ทันที — แพลตฟอร์มยังอยู่ในช่วงทำงานร่วมกับทีม Cloudflare โดยตรง
- ผู้เริ่มต้นที่ต้องการผลลัพธ์ทันที — ใช้เครื่องมือสำเร็จรูปแทน
สิ่งที่ Clef อาจเปลี่ยนในวิธีสร้างเอเจนต์ AI
คุณค่าของ Clef ไม่ได้อยู่แค่การเปิดน้ำหนักโมเดล แต่อยู่ที่การทำให้ความสามารถในการตัดสินใจกลายเป็นสิ่งที่ทีมวัด ปรับแต่ง และตรวจสอบได้ ผ่านตัวเลข benchmark ที่เทียบกับ Jev ได้ตรงไปตรงมา และแพลตฟอร์ม RL fine-tuning ที่ใช้ RLCD ให้คะแนนบางส่วนแทนการตัดสินแบบถูก-ผิด
ก่อนนำไปใช้ในระบบหลัก ควรทดลองกับงานจริงที่มีผลลัพธ์ตรวจสอบได้ แล้วดูคุณภาพการตัดสินใจ ความสม่ำเสมอ และต้นทุนการรันระยะยาว หากข้อมูลยังไม่พร้อมหรือทีมไม่มีเวลาปรับแต่ง Clef เวอร์ชัน hosted บน Workers AI ก็ยังใช้งานได้โดยไม่ต้อง fine-tune เพิ่มเลยครับ